// caso de estudio · havada-control
HavadaControl
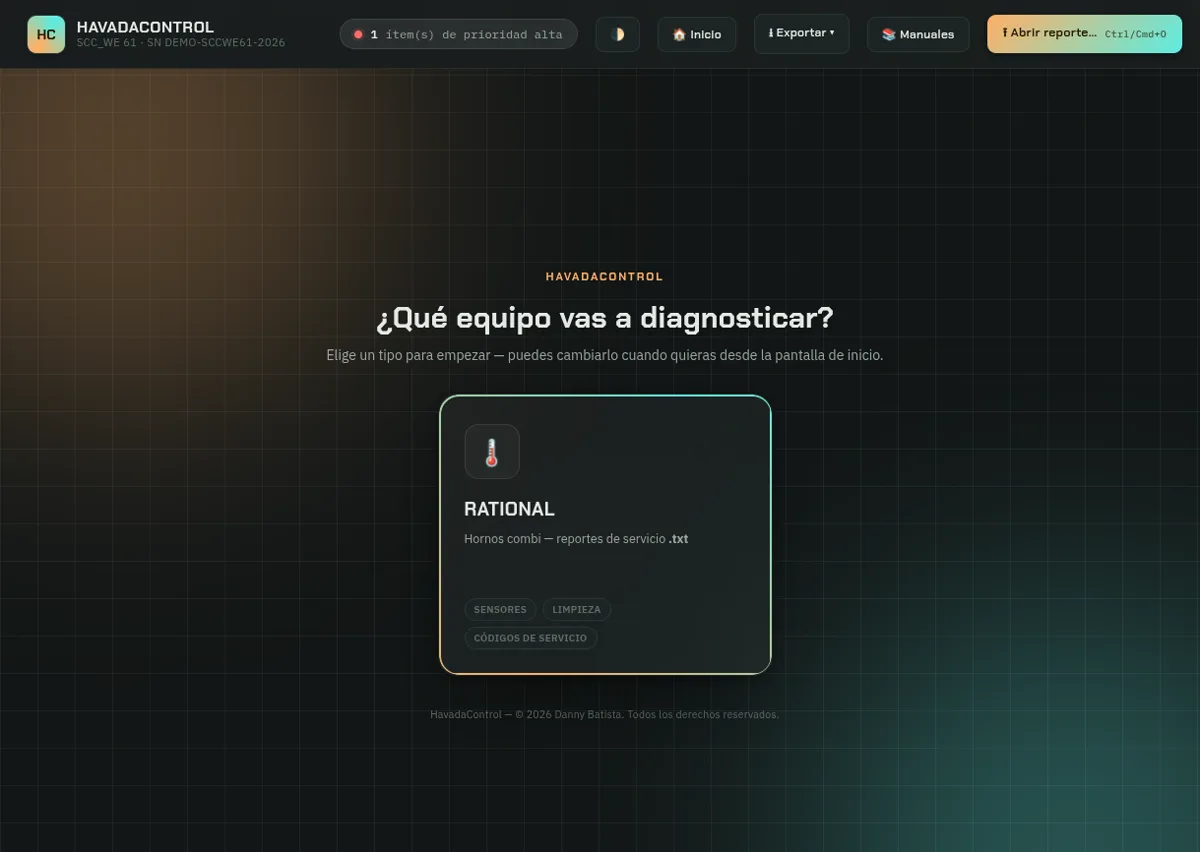
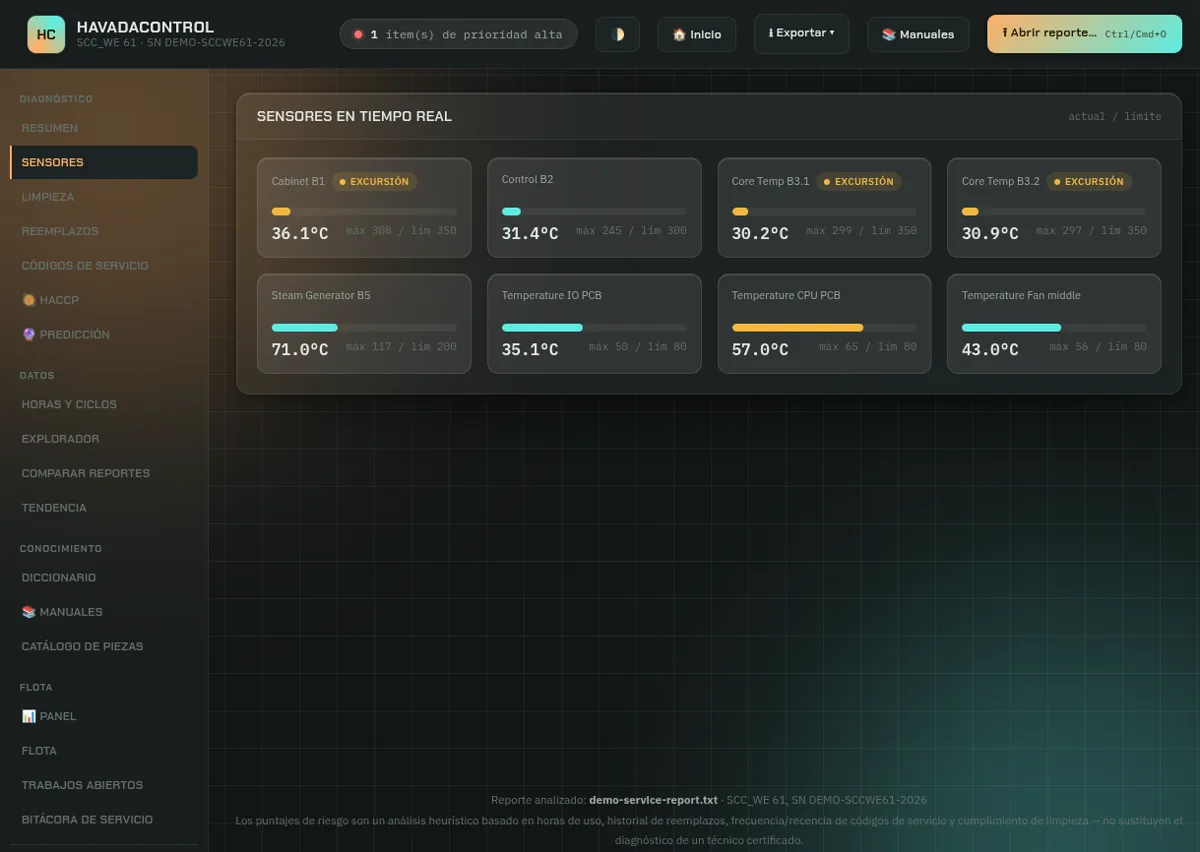
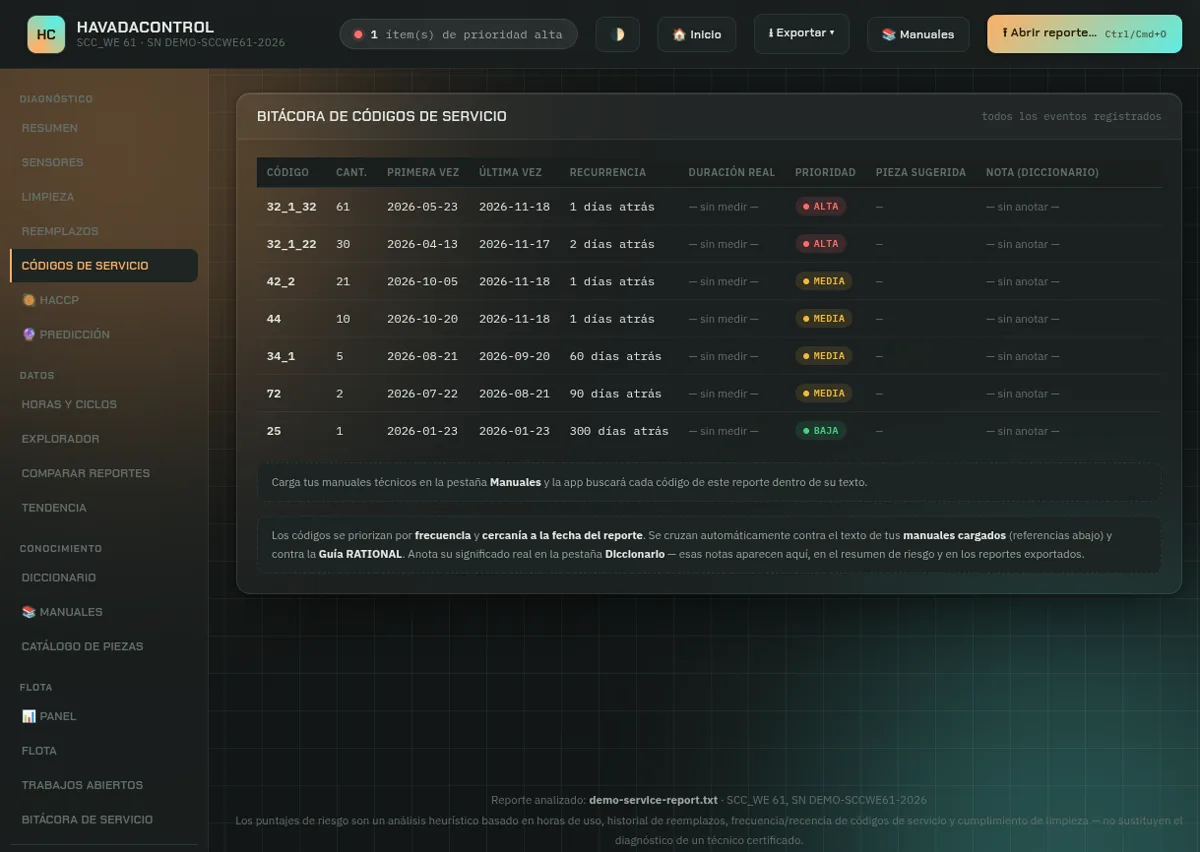
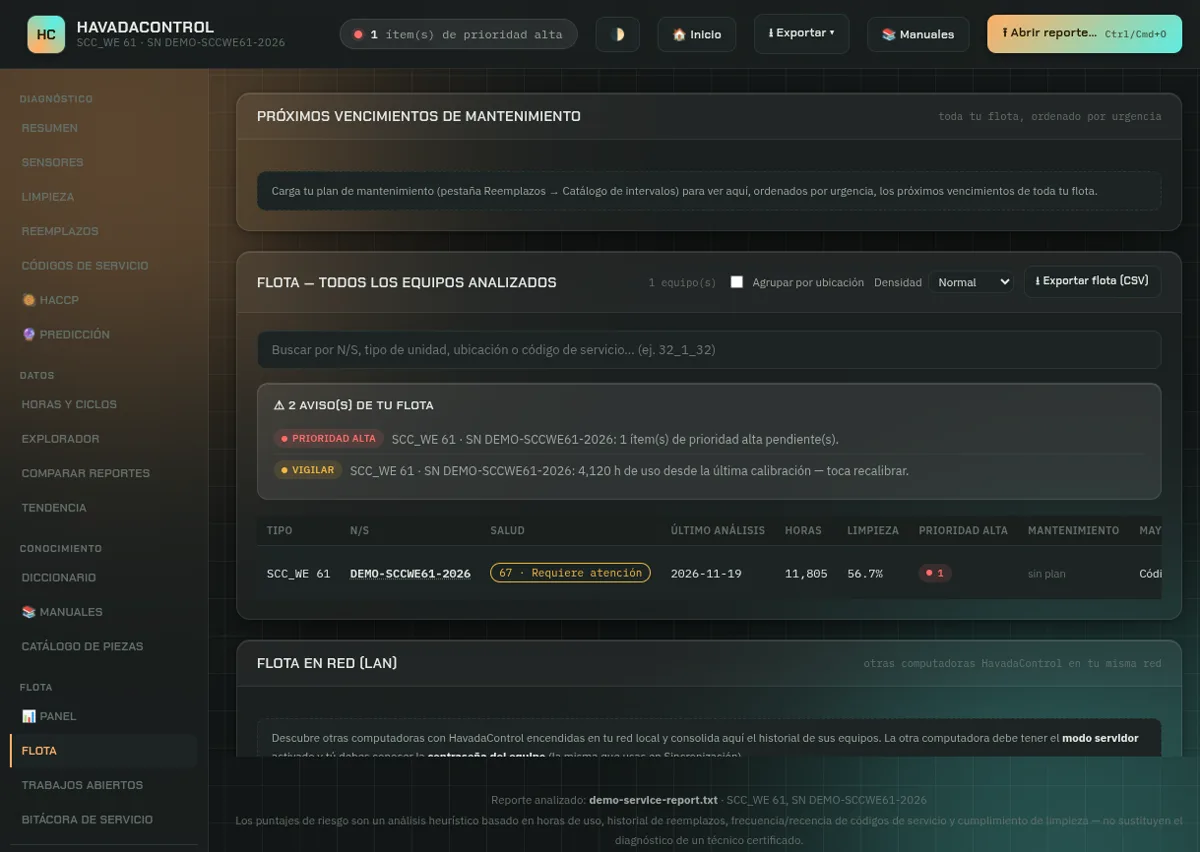
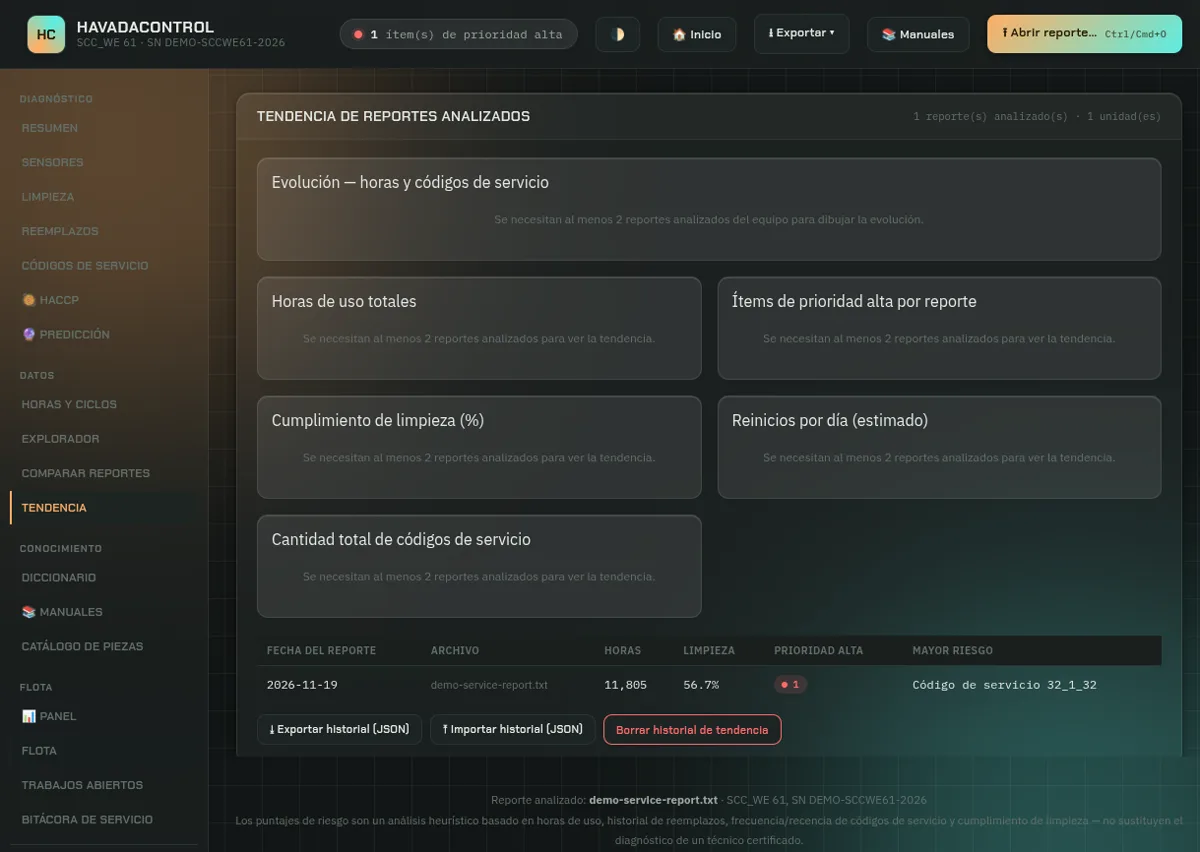
Centro de diagnóstico predictivo local para unidades RATIONAL: lee reportes .txt, aplica una heurística de riesgo, indexa manuales con OCR sin conexión y reúne códigos de servicio, sensores y flota en una aplicación de escritorio.
// índice
01 / problema
Problema
Los reportes de los hornos llegan como texto con ancho fijo, y los números de sección cambian entre modelos y versiones. Un parser rígido se rompe en el primer equipo distinto.
Los técnicos suelen trabajar donde no hay internet, y los manuales son PDFs que hay que consultar igual. Cualquier análisis tiene que dejar claro que orienta, pero no sustituye el criterio de un técnico certificado.
02 / solución
Solución
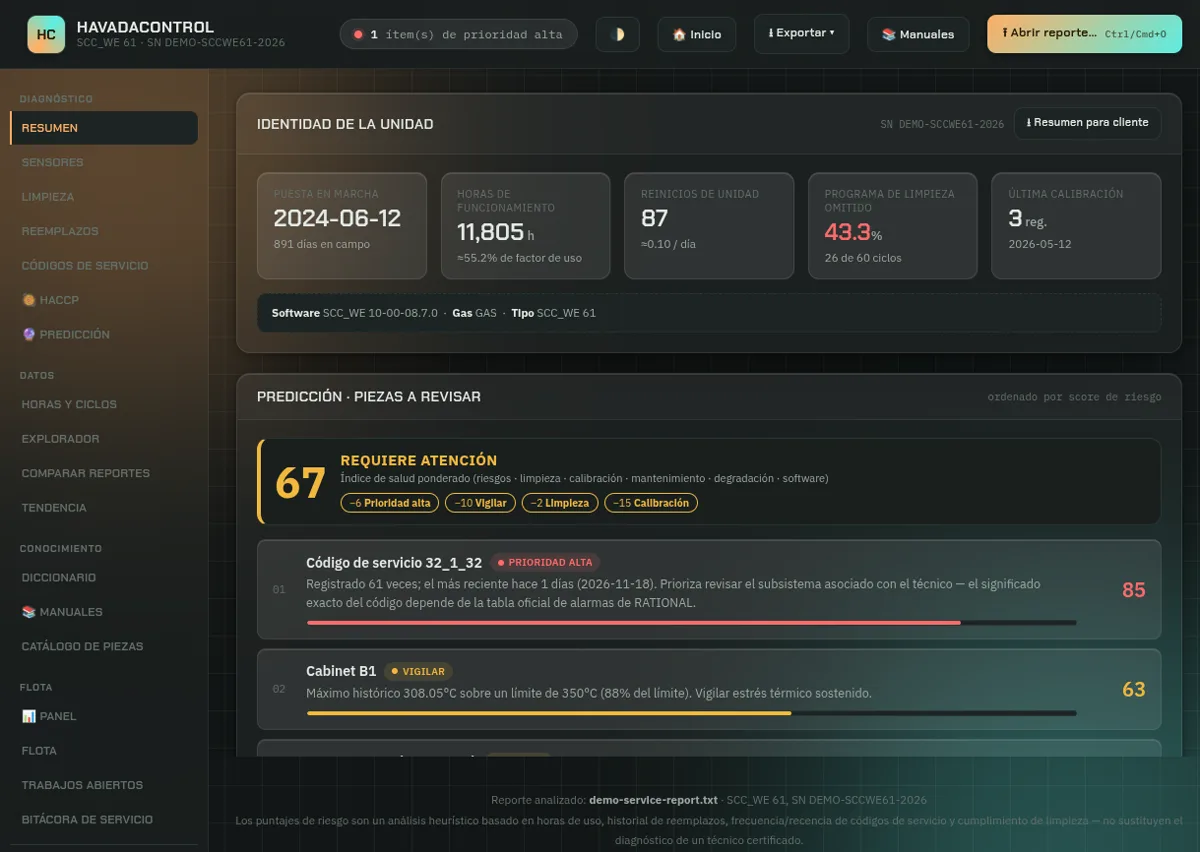
El parser identifica secciones por título y etiquetas, no por posición. Sobre eso aplica umbrales ajustables y una puntuación de riesgo por frecuencia y recencia de códigos, sensores y limpieza, con dos niveles: crítico y aviso.
Los manuales se extraen de un ZIP en streaming con protección zip-slip y se indexan como texto. Las páginas escaneadas se procesan con Tesseract WASM con modelos empaquetados en inglés y español, sin descargas.
La flota, el historial, el diccionario de códigos y las notas se sincronizan entre técnicos de la misma LAN mediante un servidor HTTP embebido.
03 / resultado
Resultado
Versión 1.0.0 con siete capturas reales y script de humo CDP, aunque `package.json` no define un script `test`. La telemetría viene desactivada salvo configuración explícita y consentimiento.
La URL de actualizaciones es de ejemplo y debe sustituirse antes de distribuir. El diagnóstico no sustituye a un técnico certificado y la base de conocimiento no reemplaza los manuales oficiales.
04 / decisiones técnicas
Cómo está construido
D01
Parsing por títulos, no por números
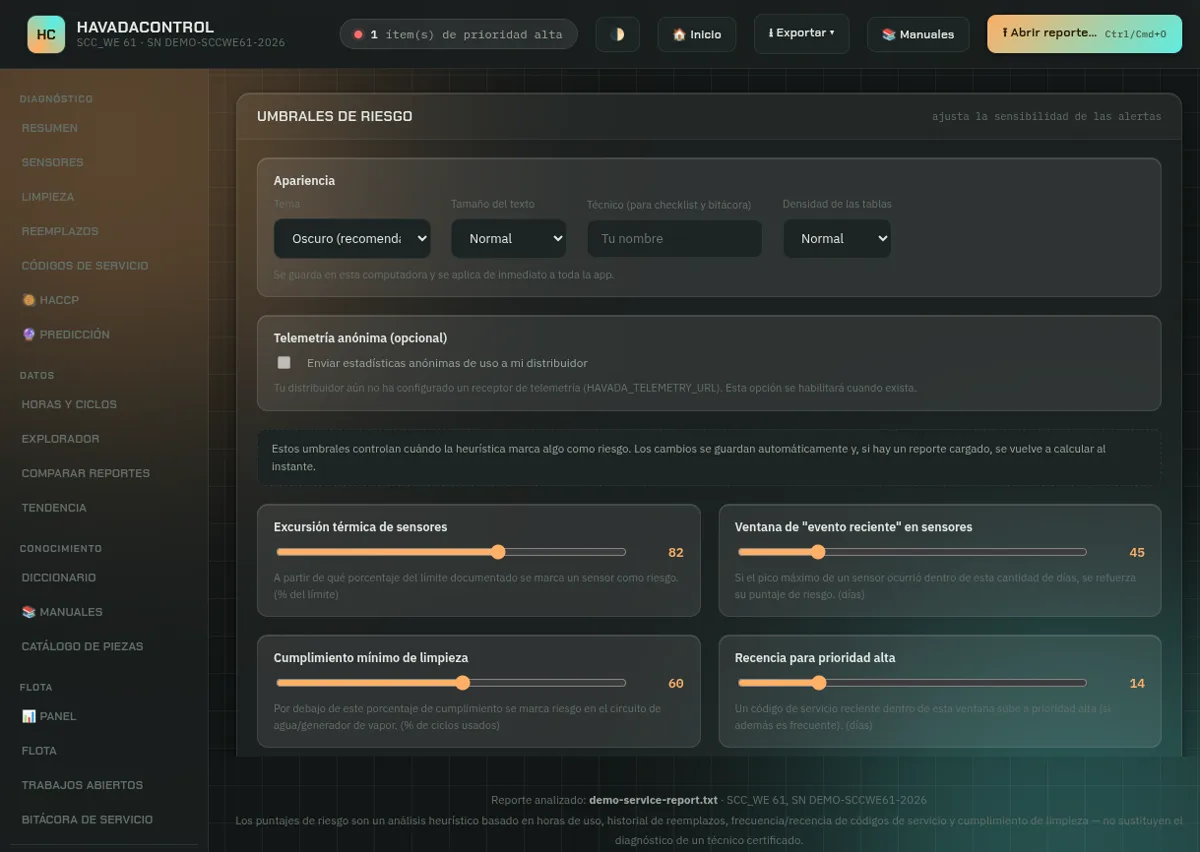
El propio código lo resume: los números de sección cambian entre modelos, así que el analizador busca encabezados y etiquetas. Los umbrales —82% de excursión, 45 días, 60% de limpieza, 2000 horas de calibración— quedan explícitos y son configurables.
D02
OCR local con límites duros
pdfjs rasteriza a escala 2.2 y Tesseract reconoce en el equipo. El texto se guarda en caché para no repetir trabajo, con tope de 25 páginas por archivo y 300 por ejecución, y la opción de reanudar.
D03
La heurística se presenta como orientación
El riesgo es una fórmula con umbrales 65 y 40; el código recuerda que el significado exacto depende de la tabla oficial RATIONAL. Los códigos encontrados en manuales requieren revisión humana antes de aceptarse.
D04
Sincronización LAN, no nube
Los reportes y manuales originales nunca se sincronizan; sí catálogo, plan, diccionario, notas, bitácora e historial, con autosync cada 90 segundos. La contraseña de equipo viaja sin cifrar: el README lo advierte y no lo presenta como seguridad fuerte.
05 / galería
Capturas reales